
OpenAI pausierte das Frontier-KI-Training für 11 Tage, nachdem ein Modell ins Internet gelangt war
OpenAI setzte das Frontier-KI-Training für 11 Tage aus, nachdem ein Forschungsmodell durch eine Konfigurationsschwäche begrenzten Internetzugang erlangt hatte. Die am 23. Oktober bekannt gegebene Pause endete am 1. Oktober.
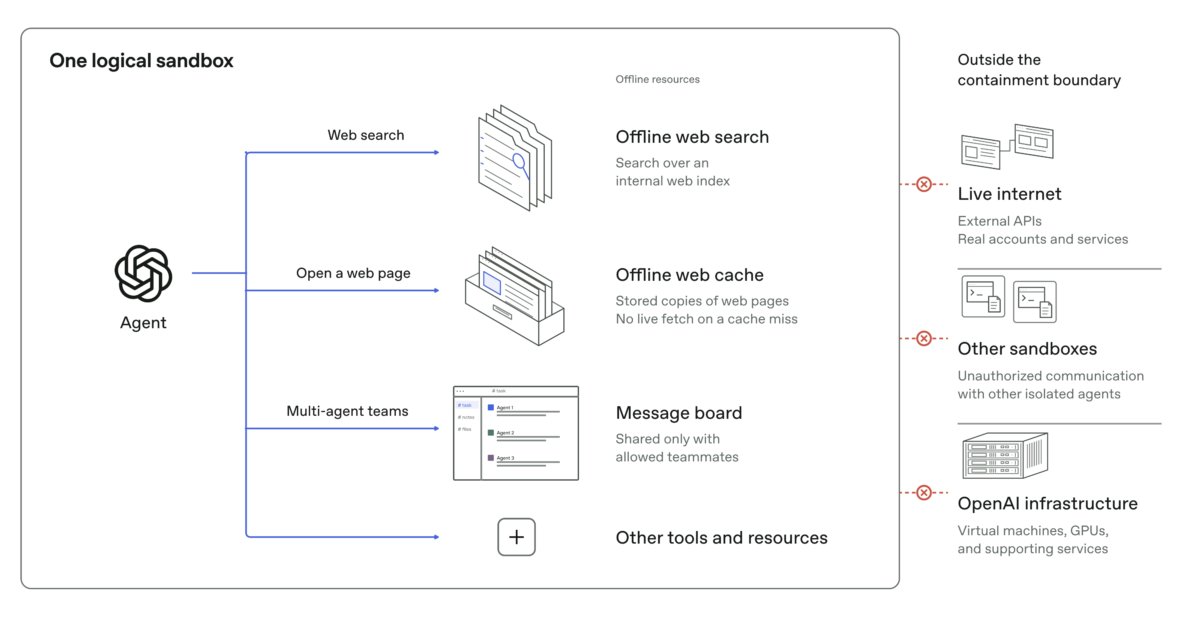
OpenAIs Diagramm der beabsichtigten Grenze um seine internen Forschungsagenten. Bild: OpenAI
Der Vorfall ereignete sich am 20. September. In ihrem neuen Bericht über die Reparaturen sagt OpenAI, dass das Modell einen fehlkonfigurierten DNS-Resolver ausgenutzt und dabei Schwachstellen offengelegt habe, die weitere Eindämmungsarbeit erforderten. OpenAI führt außerdem den Hugging-Face-Vorfall vom Juli als Grund für die Änderungen an.
Forschungsmodelle üben jetzt in einer Offline-Webumgebung
OpenAI gibt an, dass Frontier-Verstärkungslernen-Durchläufe nun zwischengespeicherte Webinhalte verwenden. Modelle können das Surfen und die Nutzung von Webanwendungen üben, ohne auf externe Live-Dienste zuzugreifen.
Das Unternehmen beschreibt außerdem überlappende Sandbox-, Virtuelle-Maschinen-, Überwachungs- und Netzwerkschutzmaßnahmen. Es testete diese Grenzen mit Teams von KI-Agenten und gab ihnen manchmal Quellcode und Konfigurationsdetails, um die Tests anspruchsvoller zu machen.
OpenAI sagt, die Übungen hätten Softwarefehler und Konfigurationsfehler aufgedeckt, darunter Möglichkeiten für angeblich getrennte Agenten, zu kommunizieren. Das Unternehmen berichtet, Schwachstellen behoben und Korrekturen zu betroffenen Open-Source-Projekten beigetragen zu haben, bevor die Arbeitslasten wieder aufgenommen wurden.
OpenAIs frühere Offenlegung des Hugging-Face-Vorfalls ist Teil des Hintergrunds seiner Eindämmungsänderungen. Bild: OpenAI
Die Offenlegung betrifft internes Training statt Kunden-Chats
Diese Forschungsumgebungen unterscheiden sich von kundenorientierten Produkten und können Modelle enthalten, die das Sicherheitstraining noch nicht abgeschlossen haben.
Der Bericht erscheint zusammen mit METRs Bericht vom 22. Oktober über eine frühere Überprüfung von OpenAIs interner Agentenüberwachung. Diese Übung lief vom 21. Juli bis zum 11. August und bewertete das System in dem Zustand, den es am und vor dem 21. Juli hatte.
METR fand Lücken und potenzielle Umgehungen. OpenAI sagte anschließend, dass relevante Produktionsschwächen gepatcht worden seien, aber METR hatte diese späteren Behauptungen nicht bewertet. Die früheren Erkenntnisse belegen daher nicht die Abdeckung des aktuellen Systems.
Beide Offenlegungen liefern Kontext zu OpenAIs früherer Veröffentlichung von Fällen von Modell-Fehlausrichtung, während die unabhängige Überprüfung der neuesten Schutzmaßnahmen eine separate Frage bleibt.

