
Cognition sagt, Nvidias Vera-Rubin-Rack habe ihm bis zum 4,8-Fachen des Token-Durchsatzes des GB200 geliefert
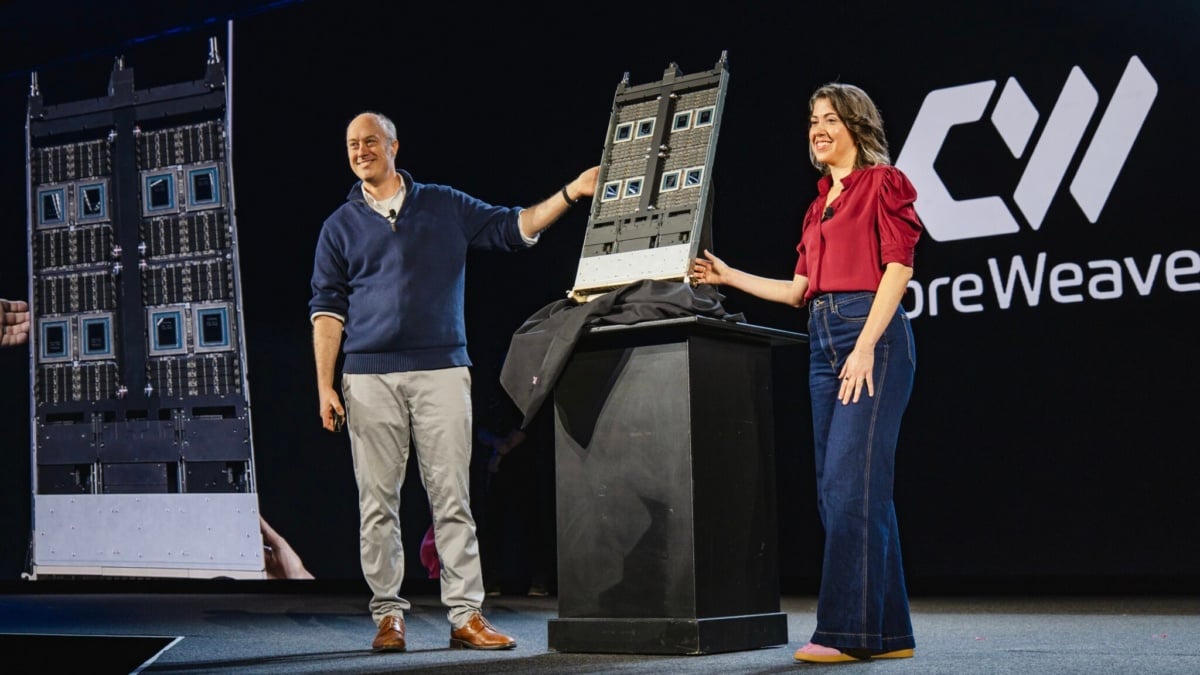
Cognition, das Labor hinter dem Coding-Agenten Devin, gibt an, dass Nvidias Vera-Rubin-NVL72-Rack in ersten Tests „eine bis zu 4,8-fache Steigerung des gesamten Token-Durchsatzes bei SWE-2-Inferenz-Workloads gegenüber GB200 NVL72“ erreicht habe. Die Zahl stammt aus Nvidias Beitrag vom 30. September über CoreWeaves Bereitstellung.
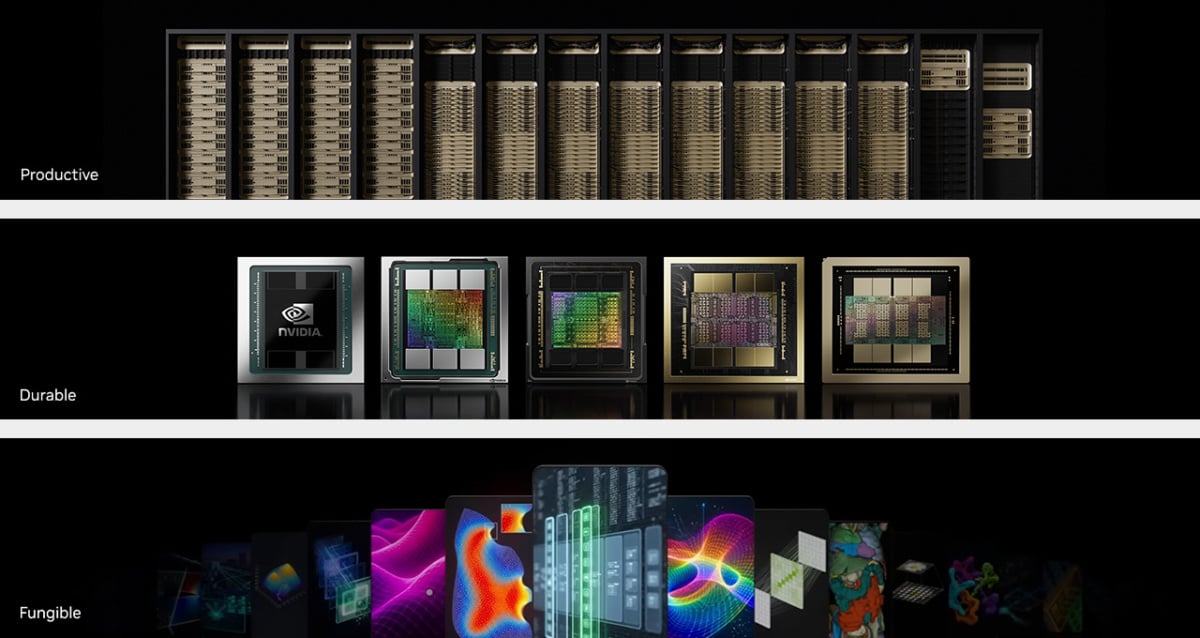
Nvidias Grafik zu der These, KI-Fabriken müssten produktiv, langlebig und fungibel sein, mit fünf seiner GPU-Generationen in einer Reihe. Bild: Nvidia
CoreWeave kündigte die Verfügbarkeit von Vera-Rubin-NVL72-Systemen mit Spectrum-X-102.4T-Ethernet-Netzwerk auf seiner Veranstaltung „Fully Connected“ in San Francisco an und nannte Cognition als „ersten Kunden, der Produktions-Workloads auf Vera Rubin ausführt“. CoreWeave erhielt im September seine ersten Vera-Rubin-Produktions-Racks.
Der 4,8-fache Wert ist eine Obergrenze bei einem Workload und keine allgemeine Beschleunigung. Cognition baute den Test auf, indem es eine Teilmenge von Aufgaben aus FrontierCode auswählte und KI-Agenten darauf ansetzte, sie zu lösen, und anschließend die SWE-2-Inferenz gegen eine GB200-NVL72-Baseline maß – das Rack der Blackwell-Generation, auf dem das Unternehmen bereits arbeitet. Die Zahl stammt vom Kunden selbst, aus ersten Tests, und niemand außerhalb der beiden Unternehmen hat sie überprüft.
Die CPU-Seite trägt die Zahlen auf Rack-Ebene
CoreWeave wird außerdem Nvidia Vera anbieten, die Nvidia als „die erste CPU, die für KI-Agenten gebaut wurde“, bezeichnet. CoreWeaves Bereitstellung „steckt 128 CPUs und 11.264 Kerne in ein einziges Rack, genug für mehr als 11.000 gleichzeitige Umgebungen mit jeweils einem Kern“, so Nvidia – eine Rechnung auf Basis der Kernanzahl, kein gemessenes Ergebnis zur Gleichzeitigkeit.
Daneben stehen zwei Messungen, und keine nennt die Hardware, gegen die gemessen wurde. Nvidia sagt, Tests zeigten mehr als 3-mal schnellere agentische Sandbox-Starts auf Vera-CPU und dass „CoreWeave auf Terminal-Bench einen Leistungsgewinn von 1,7x auf Vera-CPU über alle bestandenen Aufgaben hinweg verzeichnete“. Sandboxen sind die isolierten Umgebungen, in denen ein Agent Code ausführt; die Startzeit ist also die Steuer, die bei jedem Hochfahren einer solchen Umgebung fällig wird – und diese Sandboxen laufen parallel zu den Trainings-Jobs, die sie unterstützen. Nvidia zufolge sind die Umgebungen hardware-isoliert; Spectrum-X-Ethernet-Switches und BlueField-4-DPUs wickeln den Datenverkehr zwischen ihnen ab.
Nvidias Argument ist, dass alte Racks weiter Geld einbringen
Ian Buck, Nvidias Vice President für Hyperscale und High-Performance Computing, nutzt CoreWeaves älteste Hardware, um das zu untermauern. „CoreWeaves NVIDIA-V100-GPUs führen fast ein Jahrzehnt nach dem Start von Volta immer noch Kunden-Workloads aus, selbst während CoreWeave Vera Rubin NVL72 in Produktion bringt“, sagt er.
Cognitions eigener Fokus liegt auf den Kosten statt auf der Spitzenleistung. „Agentisches Codieren ist ein komplexer Workload: lange Kontexte, hohe Gleichzeitigkeit und Token-Volumina, bei denen die Kosten pro Token darüber entscheiden, was wir ausliefern können“, sagt Silas Alberti aus dem Gründungsteam von Cognition. Das Unternehmen skalierte laut Nvidia innerhalb von neun Monaten auf Tausende von GPUs bei CoreWeave und führt dort Training, Reinforcement Learning und Produktions-Inferenz für Devin beim selben Anbieter aus.
Agenten-Tooling ist der Bereich, in dem die Nachfrage geltend gemacht wird: Wir haben am 4. Oktober berichtet, dass OpenAI nach eigenen Angaben die Inferenz von Astra Ultrafast auf Nvidia-GPUs optimiert hat – jener Blackwell-Generation, zu der auch Cognitions Baseline gehört.
Was noch fehlt
Nvidia nennt weder einen Preis für ein Vera-Rubin-NVL72-Rack, noch eine Zahl, wie viele CoreWeave installiert hat, noch einen Termin für die allgemeine Verfügbarkeit über die Ankündigung hinaus. Es gibt keinen unabhängigen Benchmark, keine Angabe zur Leistungsaufnahme und keinen Vergleich bei gleichen Kosten statt bei gleichem Rack. CoreWeave hat außerdem Forge vorgestellt, das es als vernetzte Umgebung zum Trainieren, Evaluieren und Verbessern von Modellen und Agenten beschreibt. Bis ein zweiter Kunde Zahlen veröffentlicht, ist 4,8x die frühe Messung eines Labors für einen einzigen Coding-Workload.

