
Anthropic erreicht mit Opus 5.5 66,4 % bei Terminal-Bench, hat den Test aber selbst durchgeführt
Anthropic gibt an, dass Claude Opus 5.5 im Terminal-Bench 4.0 66,4 % erreicht – ein agentischer Coding-Test, den das Unternehmen selbst ausgeführt und am 22. September zusammen mit dem Modell veröffentlicht hat. Die öffentliche Terminal-Bench-Bestenliste, die am selben Tag geprüft wurde, enthält überhaupt kein Ergebnis für Opus 5.5; ihr Spitzeneintrag ist GPT-6 Astra (max) mit 58,2 %.
GPT-6 Astra führt die öffentliche Terminal-Bench-4.0-Bestenliste mit 58,2 % an, ermittelt über OpenAIs Codex-Harness. Bild: OpenAI
Die beiden Zahlen stammen von unterschiedlichen Stellen und passen nicht zusammen. Anthropic hat Opus 5.5 mit dem eigenen Setup bei xhigh effort ausgeführt und die 57,9 % für GPT-6 Astra aus OpenAIs Angaben übernommen, statt dieses Modell selbst auszuführen. Die Terminal-Bench-Bestenliste, die von Stanford, Harbor und dem Laude Institute betrieben wird, führt die bei ihr eingereichten Durchläufe auf; die 58,2 % an ihrer Spitze wurden über OpenAIs Codex-Harness erzielt.
Die öffentliche Bestenliste hat noch keine Zeile für Opus 5.5
Hinter GPT-6 Astra liegen Anthropics eigenes Fable 5.1 (max) mit 57,9 % über Claude Code und danach Opus 5 (xhigh) mit 53,9 %, jeweils mit einem 95-Prozent-Konfidenzintervall von rund drei Punkten. Opus 5.5 ist am 22. September erschienen, daher ist sein Fehlen in der Bestenliste eine Frage des Zeitpunkts und kein Urteil über das Modell.
Anthropic ist ungewöhnlich offen darüber, wie das Unternehmen zu dieser Zahl gelangt ist. Es nennt die Effort-Einstellung, einen Standardfehler von ±2,6 Punkten und einen Abgleich mit dem eigenen Harness: Die öffentliche Bestenliste bewertet Opus 5 mit 51,8 %, und Anthropics Setup kommt für dasselbe Modell auf 52,3 % – was das Unternehmen als im Rauschen liegend bezeichnet.
Ein eigener Durchlauf eines Anbieters bleibt ein eigener Durchlauf eines Anbieters. Solange Terminal-Bench keine Opus-5.5-Einreichung verzeichnet, sind die 66,4 % eine Selbstvermessung von Anthropic und lassen sich nicht mit den 58,2 % der öffentlichen Bestenliste vergleichen, als wären beide aus demselben Harness hervorgegangen.
GPT-6 Astra gewinnt zwei Zeilen in Anthropics eigenem Vergleich
Anthropic stellt neun Benchmarks gegenüber, und Opus 5.5 verliert zwei davon gegen GPT-6 Astra, das OpenAI-Modell, das eine seit 2005 ungelöste Enigma-Nachricht aus dem Jahr 1941 geknackt hat. Astra gewinnt AutomationBench mit 41,4 % gegenüber 40,0 % und Terminal-Bench-Science 0.1 mit 64,6 % gegenüber 58,7 %.
Anthropic gibt an, dass Zapier die AutomationBench-Werte ohne Fallback-Modelle ausgeführt und gemeldet hat; jedes Mal, wenn die Sicherheitsmechanismen von Opus 5.5 eingriffen, wurde die Aufgabe daher als Fehlschlag gewertet. In dem Vergleich erscheinen nur GPT-6 Astra und GPT-5.6 Sol als Konkurrenten; ein Google-Modell taucht darin überhaupt nicht auf.
Eine unabhängige Bestenliste hat bereits ein Ergebnis veröffentlicht
Artificial Analysis setzt Claude Opus 5.5 (max with fallback) inzwischen mit 58 an die Spitze seines Intelligence Index; die Einstellungen xhigh und high liegen bei 56 und 54, vor Claude Fable 5.1 und GPT-6 Astra mit 53. Die Spalten Kosten pro Aufgabe und Ausgabegeschwindigkeit sind bei jedem Opus-5.5-Eintrag leer, und Artificial Analysis kennzeichnet jedes aktuelle Claude-Modell, einschließlich Fable 5.1, mit „with fallback“.
Artificial Analysis besitzt außerdem GDPval-AA v2.1, den Wissensarbeitstest, für den Anthropic 1846 Elo beansprucht, gegenüber 1735 für Fable 5.1. Dieser Wert ist ein Durchlauf von Anthropic mit dem Benchmark eines Dritten, kein von Artificial Analysis veröffentlichtes Ergebnis.
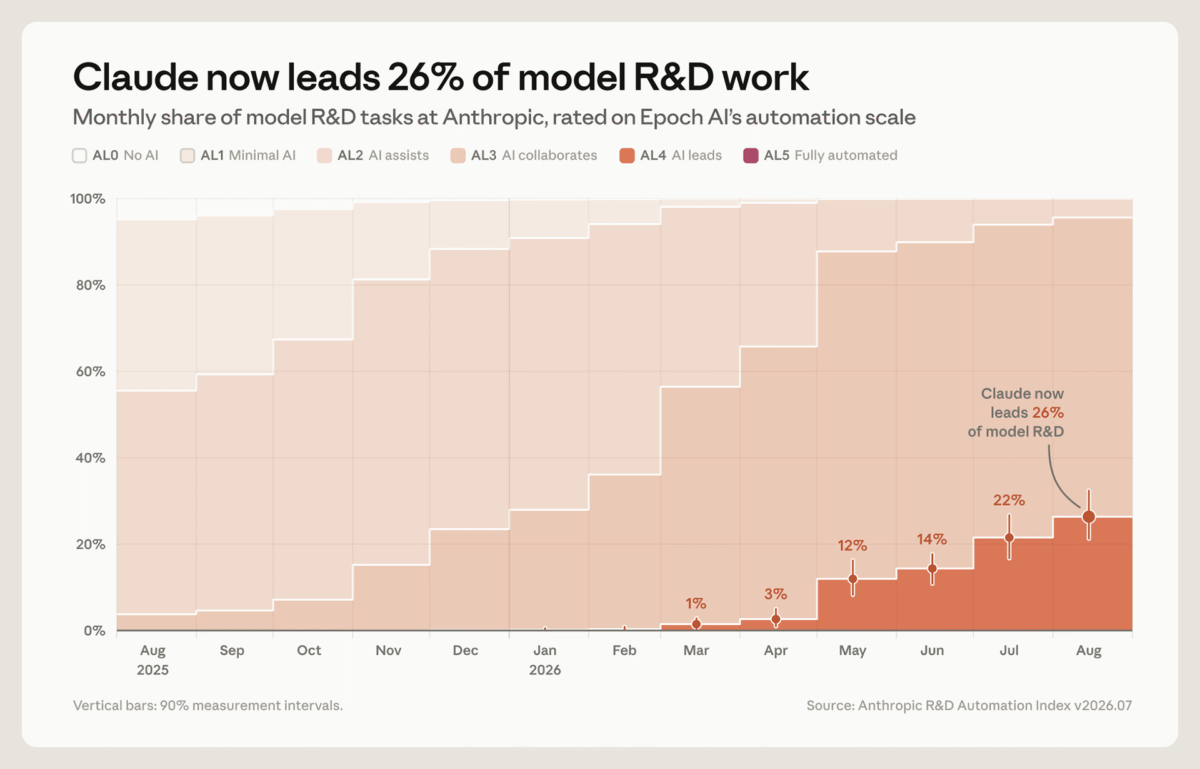
Anthropic hat die Angewohnheit, eigene Messungen der eigenen Arbeit zu veröffentlichen, darunter die Behauptung, Claude habe im August 26 % der KI-Forschungsarbeit von Anthropic geleitet. Diesmal verbindet das Unternehmen die Zahlen mit einer eigenen Warnung: Auf diesem Fähigkeitsniveau, so Anthropic, seien Benchmark-Abstände „ein weniger verlässlicher Leitfaden für reale Unterschiede geworden“, und im eigenen Einsatz sei der Abstand zwischen Opus 5.5 und Fable 5.1 geringer, als die Werte vermuten lassen.

