
Nvidia zielt mit einem auf ein 4-GB-Speicherbudget ausgelegten Modell auf lokale KI-Assistenten
Nvidia hat ein kleines KI-Modell veröffentlicht, das lokale Sprachassistenten, Spielfiguren und Roboter antreiben soll und dabei Speicher für den Rest der Anwendung verfügbar lässt. Nemotron 3.5 Bolt E4B 4GB ist am 23. Oktober mit herunterladbaren Gewichten und Unterstützung für Tools wie Ollama und LM Studio erschienen.

Nvidias Benchmark-Vergleich nutzt ausgewählte Tests und Hardware-Konfigurationen. Bild: Nvidia
Das Modell baut auf Googles Gemma 4 E4B auf und ergänzt Nvidias Training für Konversationen und Aktionen über mehrere Dialogrunden. Es kann Anwendungs-Tools aufrufen, die Persönlichkeit einer Figur beibehalten und einen Konversationsmodus verwenden, der kürzere, sprachfreundliche Antworten erzeugen soll.
Die 4-GB-Angabe hängt davon ab, was das Modell gerade tut
Nvidias veröffentlichte Messwerte zeigen, warum die Bezeichnung Kontext braucht. Auf einer RTX 5070 belegte das komprimierte Modell in einem kurzen Test mit etwa 3.000 Eingabe-Tokens und 50 Ausgabe-Tokens 3,5 GB Grafikspeicher. Ein Test, der 32.000 Tokens Kontext behielt, belegte 4,3 GB.
Die Messwerte für Jetson Orin Nano lagen bei diesen Workloads zwischen 4,2 GB und 4,9 GB. Dies sind Nvidias Ergebnisse für bestimmte Einstellungen, nicht ein Versprechen, dass jede Konversation unter 4 GB passt. Das Modell unterstützt ein Kontextfenster von bis zu 64.000 Tokens.
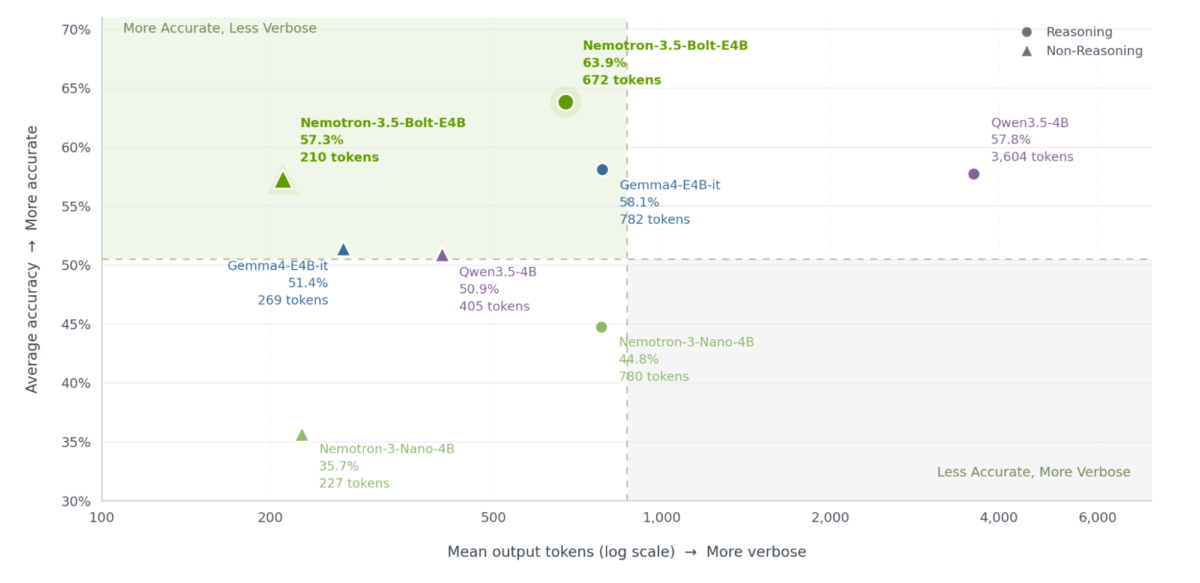
Nvidia vergleicht Ausgabelänge und Benchmark-Genauigkeit der getesteten Modelle. Bild: Nvidia
Sie können es herunterladen, statt jede Anfrage an einen Cloud-Dienst zu senden
Die offizielle Modellseite stellt das komprimierte GGUF-Release und Anleitungen für lokale Inferenz-Tools bereit. Nvidia veröffentlicht außerdem Trainingsrezepte und ein separates Drafter-Modell, das die Generierung beschleunigen soll.
Das Reasoning kann für komplexere Anfragen eingeschaltet oder für schnellere Antworten ausgeschaltet werden. Das Release zielt auf GeForce-RTX-PCs, Jetson-Systeme, RTX Spark und DGX Spark ab und erweitert die lokale KI-Arbeit hinter Nvidias größeren DGX-Spark-Setups auf kleinere Konversations-Workloads.
Nvidia meldet höhere durchschnittliche Benchmark-Werte als beim bisherigen Nano-4B-Modell, aber die eigenen Tabellen zeigen auch, dass Wettbewerber in einzelnen Tests vorn liegen. Anwendungsentwickler müssen weiterhin prüfen, ob das Modell ihre jeweiligen Aufgaben zuverlässig erfüllen kann.

